2026年10月30日(周五),临床与健康心理学系举办第六次博士生学术分享与交流会。周广玉课题组博士生王曦以“AI×健康心理学”为题,结合乙肝污名、心理健康评估和大语言模型伦理等研究,介绍人工智能在心理数据分析、心理评估、心理干预及科学验证中的应用。
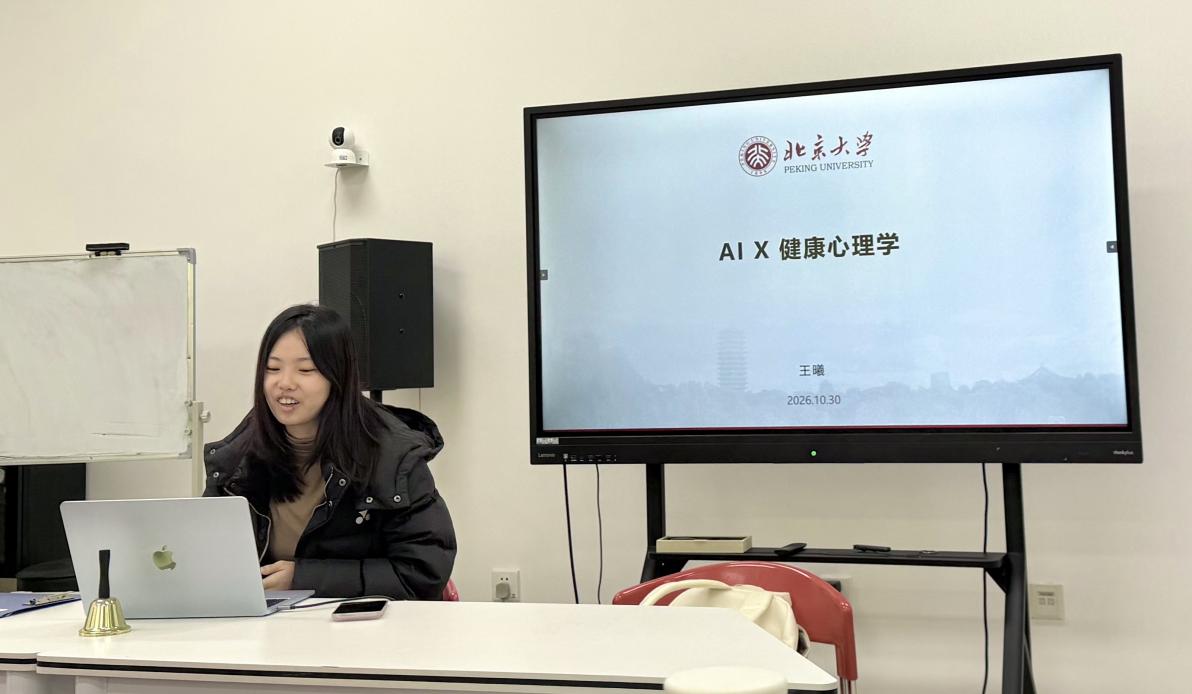
王曦 AI×健康心理学学术报告
报告首先从健康心理学研究中的实际问题出发,说明人工智能可以参与从资料整理到研究检验的多个环节。在数据分析部分,王曦以乙肝相关污名研究为例,介绍如何利用大语言模型分析益友论坛的35,697篇帖子,从自然语言中识别污名表达和认知歪曲。结果显示,污名化文本中的认知歪曲出现频率更高,其中“贴标签/错误标签”最为突出,用户层面的分析也得到相近结果。与问卷和访谈相比,日常语言材料能够呈现患者反复出现的消极思维模式,为认知行为干预寻找更具体的切入点。
随后,报告介绍了ScaleLLM在健康评估中的应用。该方法将结构化量表答案转化为自然语言,并补充心理学、统计学和外部知识,在无需针对具体任务另行训练监督预测模型的情况下,输出风险分类和相应解释。围绕心理干预,王曦结合一项纳入79篇研究的系统综述,梳理大语言模型在诊断评估、治疗性工具和临床人员支持中的使用方式。现有研究显示了其在情绪支持和行为改变等方面的潜力,但个性化不足、建议笼统、危机情境安全性不够等问题仍然存在,实际应用离不开专业判断和安全机制。
报告最后聚焦模型自身可能带来的健康污名。两项相互配合的研究发现:在显性量表测试中,六个主流大语言模型的污名得分大多低于人类基准。但在51个现实社会情境中,仅改变主人公的健康状况,模型的判断和回应就会发生系统性变化。心理健康问题以及HIV、乙肝相关标签更容易引发污名化倾向,中文输入下这一现象在部分条件下更为明显。
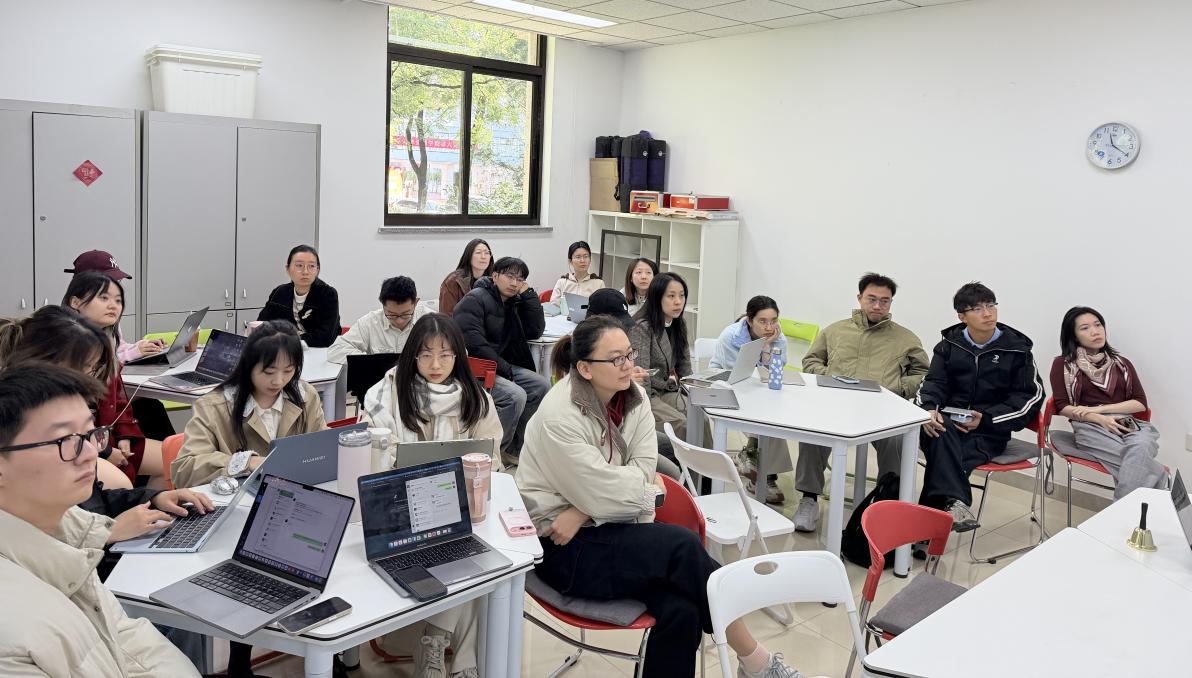
学术分享与交流会现场
本次分享将方法介绍与研究反思放在一起:人工智能让大规模自然语言、情境化评估和适应性干预成为可检验的研究对象,也使模型偏差和伦理治理成为必须正面处理的问题。评价模型在健康场景中的公平性,这一思路为健康心理学研究设计和人工智能应用评估提供了参考。
2026-11-05